Points clés : tests en décalage vers la droite
- Le déplacement vers la gauche est nécessaire, mais ce n’est pas suffisant. Les utilisateurs réels, les volumes réels de données et l’infrastructure réelle à 2 heures du matin se comportent différemment de votre environnement de préproduction.
- La production est votre source la plus riche de signaux de qualité. Cessez de la considérer comme la fin des tests.
- Les incidents deviennent des tests de régression. Les tests de régression deviennent des garde-fous. Bouclez le processus et la même défaillance ne se reproduira jamais deux fois.
- Les tests pilotés par l'observabilité reposent sur trois fondations : l'instrumentation, une culture sans blâme et des runbooks. Sans elles, vous ne faites que générer du bruit.
- Commencez petit : un parcours critique, un SLO, un moniteur synthétique, un canari contrôlé. Construisez de manière incrémentale sur 6 mois.
- La surveillance synthétique valide que les parcours réels des utilisateurs fonctionnent du point de vue de l’utilisateur. Les déploiements canari détectent les problèmes avant qu'ils n'affectent 100 % du trafic. Les tests de chaos révèlent les hypothèses cachées.
- Les SLO transforment « l’application semble lente » en attentes de qualité mesurables qui guident les décisions de déploiement.
- Le rayon d’impact, le retour automatique en arrière et les interrupteurs d’arrêt rendent les expérimentations en production sûres, et non imprudentes.
- QE, SRE et développement alignés sur le shift-right signifient de meilleures preuves sur le comportement réel du système ; pas plus de conflits.
- L’automatisation des tests pilotée par l’IA accélère le cycle de rétroaction, transformant l’analyse des incidents en tests de régression en quelques minutes au lieu de plusieurs heures.
Introduction
Depuis des années, les conseils en ingénierie qualité vont dans une seule direction : décaler à gauche. Tester plus tôt. Impliquer l’ingénierie qualité dans les revues de conception. Détecter le défaut tant que cela coûte peu. C’est un bon conseil qui a porté ses fruits – les équipes dont j’ai fait partie ont véritablement détecté plus de problèmes plus tôt une fois que nous l’avons pris au sérieux.
Mais il y a un fossé que le déplacement à gauche ne comble jamais, et faire semblant du contraire nous a coûté quelques samedis inconfortables. Aucun test en pré-production ne prédit complètement comment de vrais utilisateurs, de vrais volumes de données et une véritable infrastructure se comportent ensemble à 2 h du matin sous une charge que vous n’avez pas simulée. L’environnement de préproduction est un modèle de la production, et les modèles omettent des éléments.
Voici ce que j'ai remarqué : les équipes qui prennent au sérieux les tests axés sur l'observabilité ne se contentent pas de détecter les problèmes plus rapidement. Elles comprennent pourquoiils se produisent. Ils passent moins de temps à deviner la cause première et plus de temps à agir sur des signaux réels. Lorsqu’ils détectent un incident, ils le priorisent en quelques minutes au lieu de plusieurs heures. Et la plus grande différence ? Ils bouclent la boucle : les incidents deviennent des tests de régression, les tests deviennent des garde-fous, et la même catégorie de défaillance ne s’échappe plus deux fois. L’automatisation des tests pilotée par l’IA accélèrecette boucle, transformant l’analyse des incidents en tests de régression automatisés en quelques minutes au lieu de plusieurs heures.
La plupart des équipes évoquent les tests shift-right. Peu nombreux sont ceux qui les mettent réellement en place. Ce qui signifie que si vous commencez maintenant, vous êtes en avance sur la courbe.
Les tests pilotés par l’observabilité – la pratique qui consiste à considérer la production comme votre source la plus riche de signaux de qualité – ne visent pas à rendre les équipes QE et SRE nerveuses. Ils ont pour but de fournir à ces deux équipes des preuves plus pertinentes sur le comportement du système quand cela compte le plus. Cet article explique concrètement à quoi cela ressemble et comment l’adopter sans générer d’anxiété.
Contexte et impact
La supervision vous indique qu’il est en panne. L’observabilité vous explique pourquoi.
La surveillance traditionnelle répond à une question oui/non : le système est-il opérationnel ? L’observabilité pose une question plus complexe : Pourquoi le système se comporte-t-il ainsi ?
Les journaux, métriques et traces fournissent à la QE une autre source de preuves sans nécessiter une nouvelle compilation. Les tests basés sur l'observabilité utilisent cette télémétrie pour comprendre ce que font les utilisateurs réels et où le système se comporte différemment des attentes.
La connexion pratique se présente ainsi :
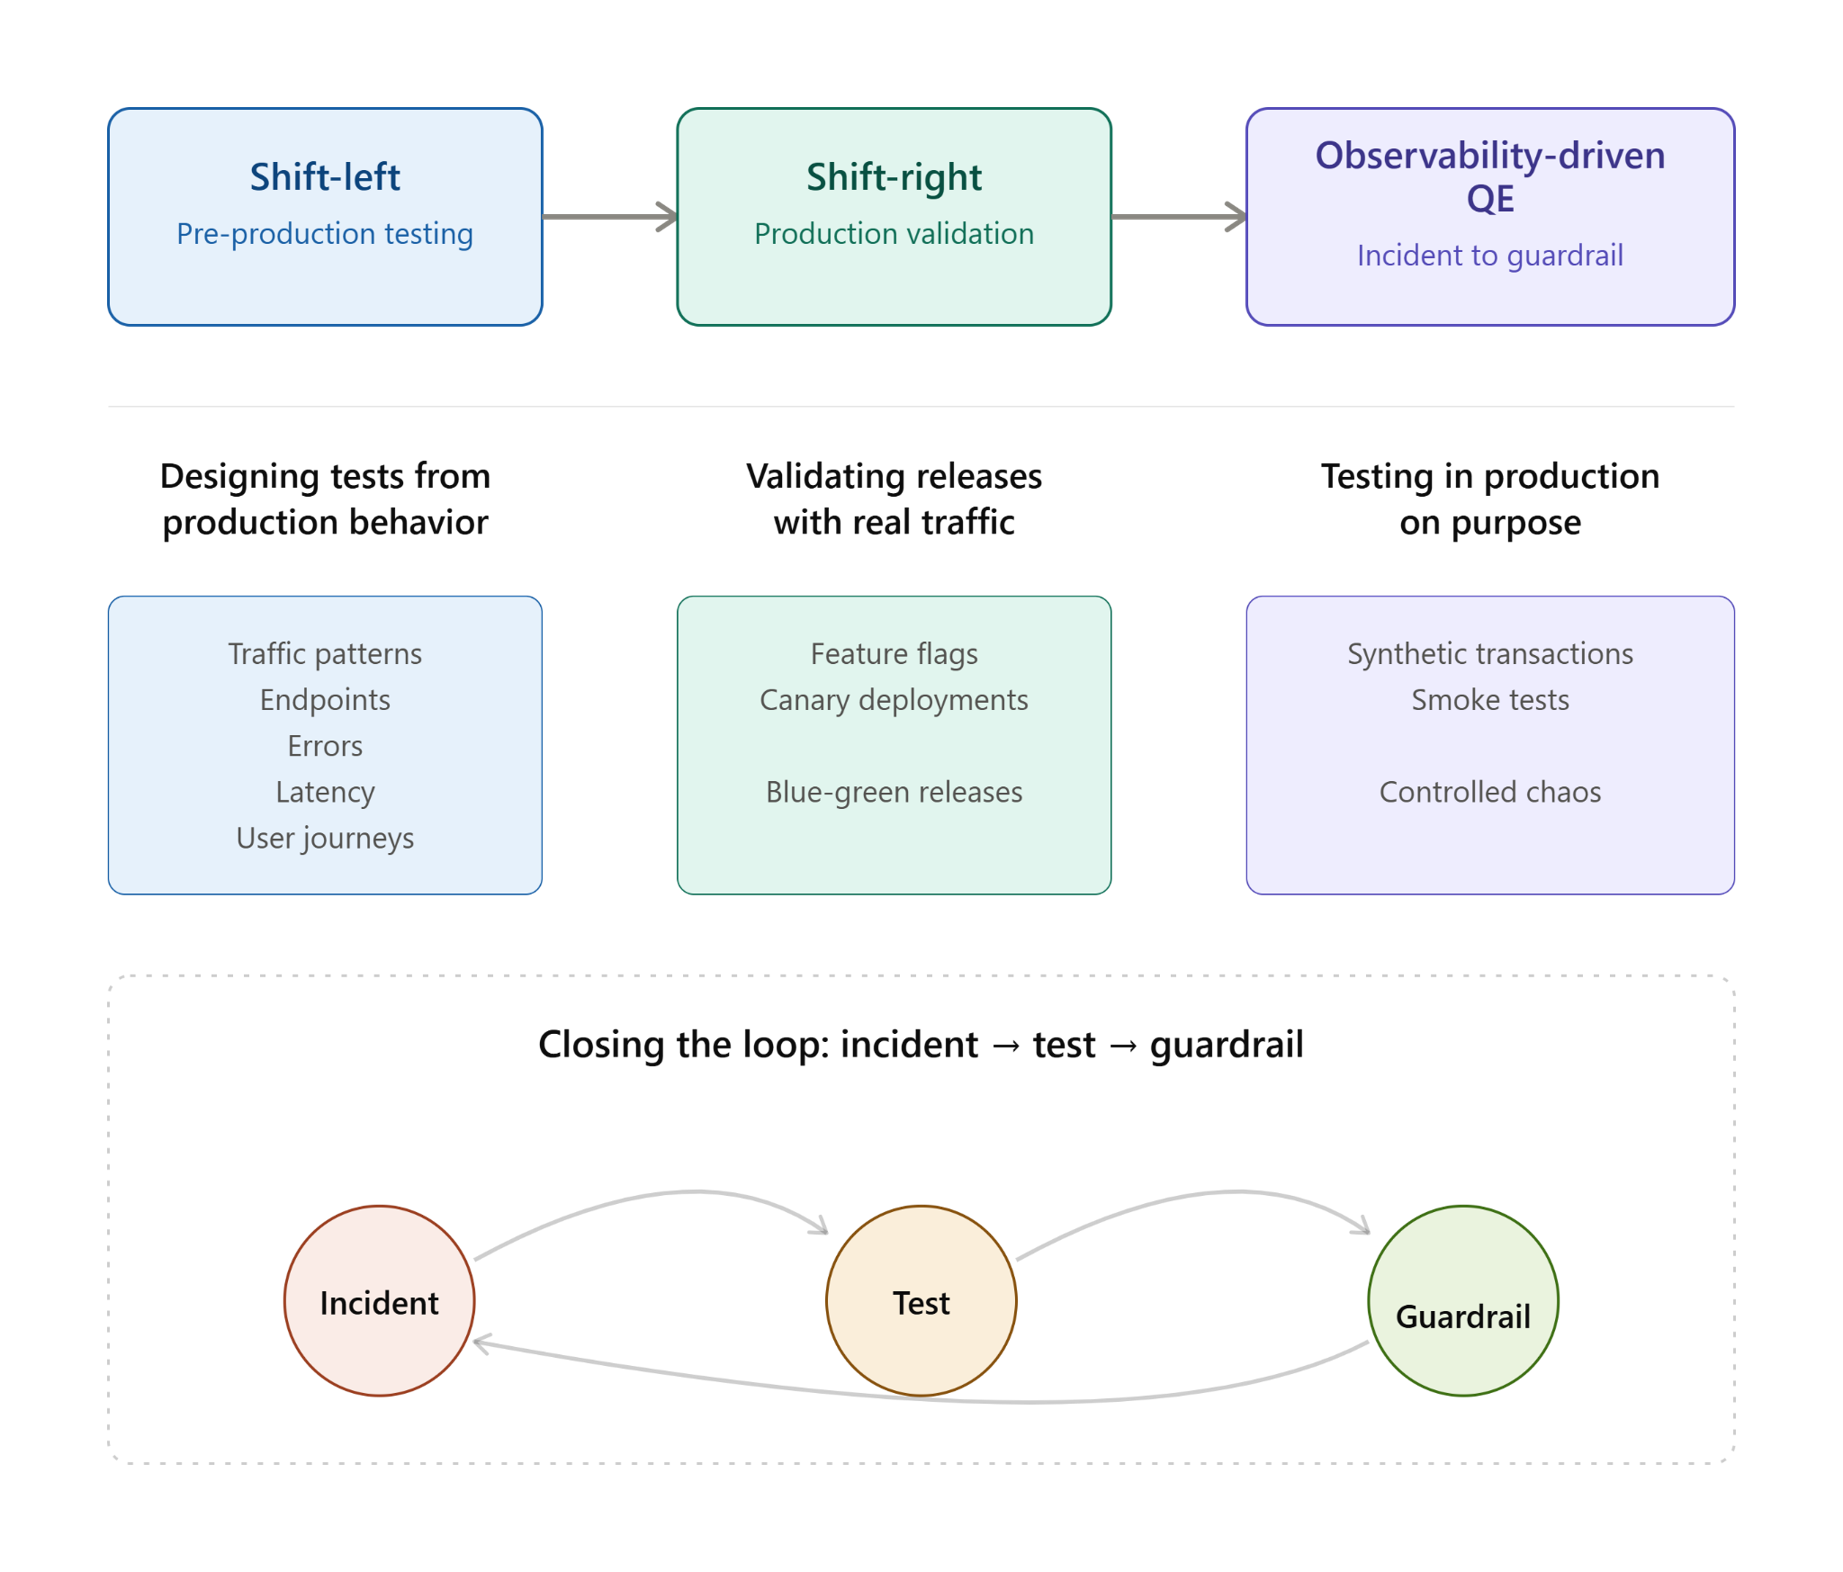
Où cela fonctionne
Les pratiques à adopter
Surveillance synthétique
Les parcours scriptés s'exécutent en production depuis plusieurs régions. L'objectif n'est pas de tester chaque fonctionnalité en continu. Il s'agit de s'assurer que les parcours utilisateurs les plus importants fonctionnent du point de vue de l'utilisateur.
Exemple — Parcours de paiement synthétique avec Playwright
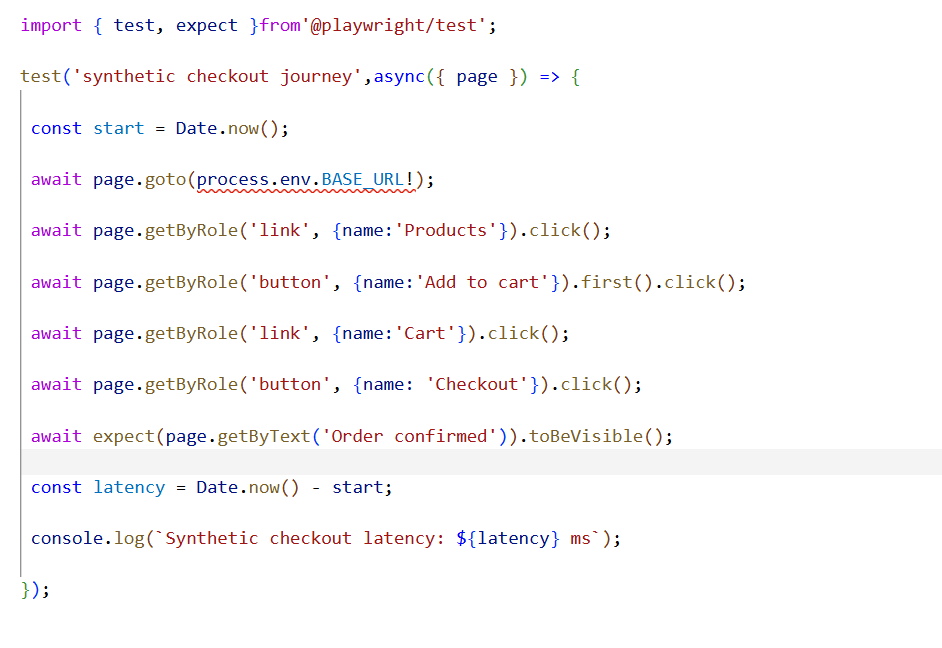
La distinction importante est que cela doit utiliser données synthétiques sécurisées et transactions, afin que le moniteur ne crée pas par inadvertance de véritables commandes, paiements ou enregistrements clients.
Analyse canari
Un faible pourcentage d’utilisateurs réels reçoit la nouvelle version pendant que le système compare la version canari à la version stable.
Un déploiement simple pourrait ressembler à : 5 % → 25 % → 50 % → 100 %
À chaque étape, comparez :
- Taux d’erreur
- Latence
- Indicateurs commerciaux
- Taux de conversion ou de finalisation
- Santé de l’infrastructure
Si le canari dépasse le seuil convenu, un retour en arrière doit s’effectuer automatiquement plutôt que d’attendre que quelqu’un remarque un tableau de bord.
Exemple — Logique de promotion Canary
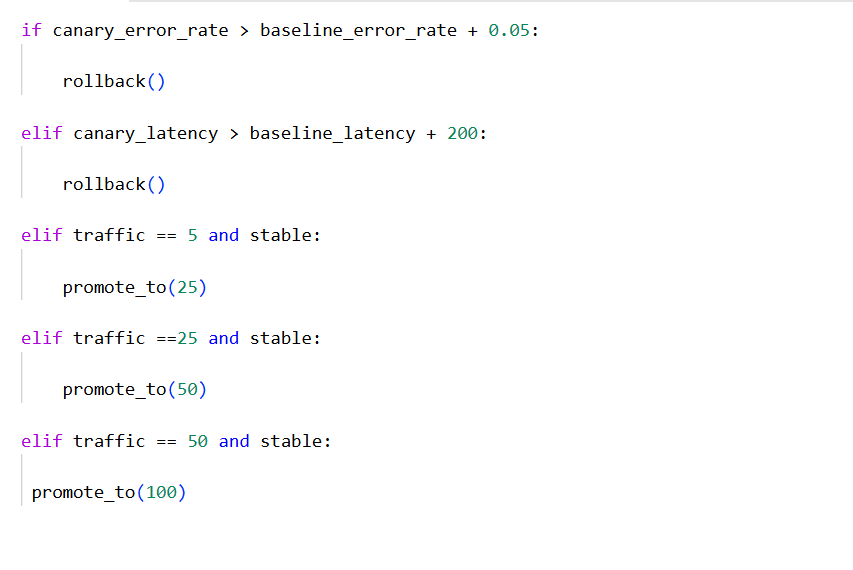
Les seuils exacts doivent être définis pour l’application plutôt que copiés aveuglément à partir d’une autre équipe.
Objectifs de niveau de service en tant que seuils de qualité
Un SLO transforme « l’application semble lente » en une attente de qualité mesurable.
Par exemple :
Vérifier le SLO
- Succès :99,5 % des demandes de paiement aboutissent avec succès durant la période de mesure mensuelle.
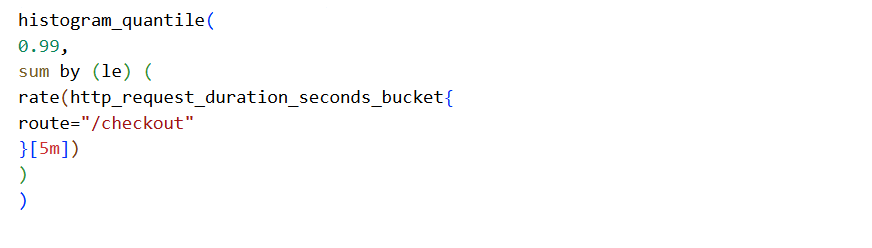
- Latence :La latence de paiement au 99e centile reste inférieure à 2 secondes.Découvrez comment valider la conformité aux SLO sous charge de production.
Cela donne à l’équipe un budget d'erreur de 0,5 %pour les demandes d'achat échouées. Lorsque le budget d'erreur est sain, l'équipe peut poursuivre la livraison normale.
Lorsque le budget est consommé rapidement, le risque de qualité devient une décision de lancement plutôt qu’une simple notification supplémentaire sur le tableau de bord.
Exemple — Requête de latence Prometheus p99
Exemple — Taux d’erreur à la caisse
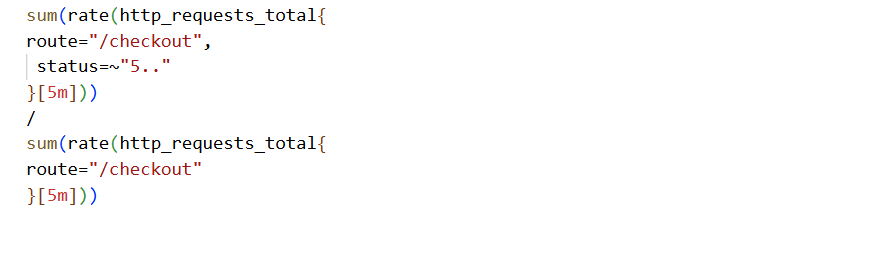
La QE ne doit pas se contenter de consommer ces chiffres. La QE doit contribuer à définir quels parcours clients sont importants, à quoi correspond un résultat « satisfaisant » et quels seuils doivent influencer les décisions de lancement.
Tests de chaos et de résilience
Les échecs contrôlés mettent en lumière des hypothèses que les tests fonctionnels normaux touchent rarement.
Le déploiement doit être réfléchi :
Étape 1 — Mise en scène
Tester les scénarios d’échec dans un environnement contrôlé.
Étape 2 — Canary en production
Introduisez l’échec dans le cadre d’un périmètre de production limité, par exemple 5 %.
Étape 3 — Expérimentations de Production Planifiées
Réalisez les expériences approuvées pendant une période définie avec les bonnes équipes disponibles.
Les scénarios possibles incluent :
- Réplique de base de données indisponible
- Ralentissement de la réponse de l’API
- Délai d’attente de dépendance
- Pression sur la mémoire
- Dégradation du réseau
Exemple — Expérience de défaillance d’une réplique de base de données
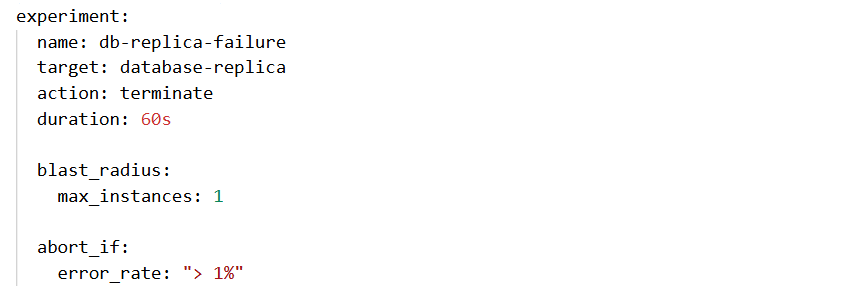
Le YAML est une définition expérimentale illustrative ; la mise en œuvre réelle dépend de la plateforme de chaos utilisée.
Chaque expérience a besoin de garde-fous : un retour automatique en arrière, un interrupteur d’arrêt, un rayon d’impact défini et des conditions d’abandon claires.
Réintégrer les incidents dans la suite
Chaque incident important doit répondre à une question :
Quel test ou garde-fou aurait permis de détecter cela plus tôt ?
Par exemple, imaginez un incident de traitement de paiement où une défaillance temporaire du fournisseur de paiement a provoqué un comportement de nouvelle tentative incorrect. L’incident est résolu, mais le travail ne doit pas s’arrêter là.
Le test de régression doit reproduire :
- La première tentative de paiement échoue temporairement.
- Nouvelle tentative.
- La deuxième tentative réussit.
- Le client voit un paiement réussi.
- Aucun double paiement n’est créé.
- La surveillance confirme le comportement attendu.
Exemple — Incident à Test
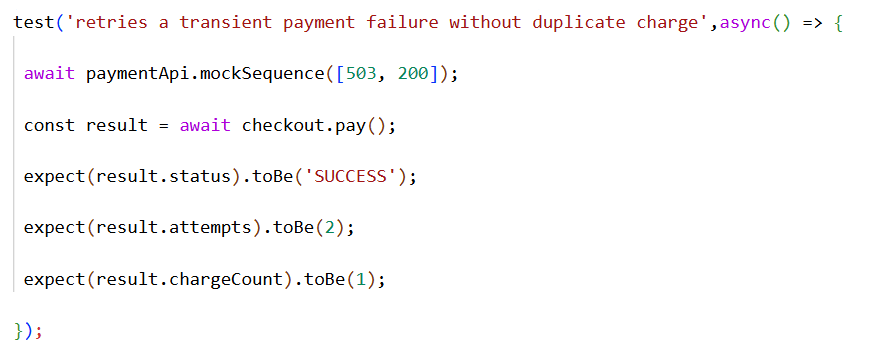
L’important n’est pas la syntaxe exacte du test. C’est la boucle de rétroaction :
Incident → Cause première → Test de non-régression → Règle de surveillance → Garde-fou futur
Outils et mise en œuvre
Écosystème d’outils
Il n’existe pas de pile d’observabilité unique et parfaite. Le choix approprié dépend de la taille, de l’infrastructure existante, de la maturité technique et du budget.
Surveillance
Datadog
Bonne option lorsqu’une équipe souhaite une plateforme d’observabilité gérée avec de larges intégrations et moins d’infrastructure à maintenir.
Prometheus + Grafana
Une option solide pour les équipes qui recherchent de la flexibilité, une base open source et qui sont à l’aise avec l’exploitation de la stack.
New Relic
Utile pour les équipes recherchant une plateforme intégrée de performance applicative et d’observabilité.
Tests synthétiques
Playwright DIY
Bien adapté lorsque l'équipe QE souhaite un contrôle maximal sur les parcours, les assertions, les données de test et l’intégration CI/CD.
Surveillance synthétique gérée
Utile lorsque l'organisation souhaite une maintenance opérationnelle réduite, une exécution distribuée et des capacités de surveillance intégrées.
Déploiement canari
Flagger
Utile pour la livraison progressive orientée Kubernetes.
Spinnaker
Une plateforme de livraison continue plus large pour les organisations ayant des exigences de déploiement plus complexes.
Contrôles de déploiement cloud-native
Souvent le choix le plus simple lorsque la plateforme cloud offre déjà les capacités nécessaires de répartition du trafic et de retour en arrière.
La décision doit commencer par le problème à résoudre, et non par le nom de l’outil.
Vous souhaitez comprendre comment l’IA accélère ces décisions ? Écoutez notre podcast sur Comment l’IA transforme l’ingénierie qualité moderne
Risques et gouvernance
Rayon d'impact
Commencez par de petits pourcentages de trafic, un retour en arrière automatique et un interrupteur d’arrêt d’urgence.
Intégrité des données
Les transactions synthétiques ne doivent jamais fausser les analyses, l'exécution, les rapports financiers ou les données clients. Le trafic de test doit être clairement identifié et isolé.
Fatigue des alertes
Lie les alertes aux SLO et à l’impact réel sur l’utilisateur plutôt que de créer des alertes pour chaque fluctuation de métrique.
Confidentialité
Les données télémetriques sensibles doivent être nettoyées, tokenisées ou exclues avant d’atteindre les systèmes d’analyse.
Préparation organisationnelle
QE, développement et SRE doivent s’accorder sur l’objectif des tests en production. L’objectif est l’apprentissage et la résilience, non la recherche de responsabilités.
Prérequis
Avant d’introduire des tests shift-right à grande échelle, je voudrais que trois éléments soient en place :
- Instrumentation— journaux, métriques, traces et télémétrie métier utile.
- Culture sans blâme— les incidents sont considérés comme des opportunités d’apprentissage.
- Manuels d'exécution— les équipes savent quoi faire lorsqu’une expérience ou un déploiement franchit un seuil.
Sans ces fondations, les tests en production peuvent générer plus de bruit que de valeur.
Feuille de route de mise en œuvre
Comment je commencerais
Plutôt que d'essayer d'implémenter tout d'un coup, je développerais la capacité mois par mois.
Mois 1 — Visibilité
Instrumentez les parcours utilisateurs les plus importants et établissez des métriques de référence.
Mois 2 — Surveillance synthétique
Automatisez les trois parcours de production critiques principaux.
Mois 3 — SLO
Définissez au moins un SLO significatif et commencez à suivre la consommation du budget d’erreurs.
Mois 4 — Canary
Canary un service unique et automatisez la comparaison entre les versions stable et canary.
Mois 5 — Chaos en préproduction
Introduisez des scénarios d’échec contrôlés en environnement de préproduction et validez le processus de retour en arrière.
Mois 6 — Chaos en production
Réalisez une expérimentation en production rigoureusement contrôlée à 5 %.
Mois 7+
Normaliser la boucle de rétroaction :
Incident → Test → Alerte → Garde-fou → Meilleure mise en production
Mesurer le succès
Objectifs chiffrés sur six mois
La référence exacte variera selon l’organisation, mais un cadre cible utile pourrait ressembler à ceci :
Métrique | Point de départ | Objectif sur six mois |
MTTD | 15 min | 2 min |
MTTR | 45 min | 12 min |
Incidents de production | 8–12/mois | 3–4/mois |
Défauts corrigés | 5–8/mois | 1–2/mois |
Pages d’astreinte | 12–15 | 3–5/semaine |
Les chiffres importent moins que l'établissement d'une base de référence et la preuve que les pratiques les font évoluer dans la bonne direction.
Conclusion et prochaines étapes
Le déplacement vers la gauche est nécessaire. Mais les systèmes modernes sont distribués, avides de données et utilisés de manière que aucun plan de test ne peut complètement anticiper.
Les tests axés sur l'observabilité étendent l'assurance qualité sur l’ensemble du cycle de vie. La télémétrie en production permet de déterminer quoi tester. Le trafic réel valide ce que les environnements de préproduction ne peuvent pas entièrement reproduire. Les incidents deviennent des tests de régression, et ces tests deviennent des garde-fous pour les futures versions.
L'objectif n'est pas de tester moins avant le lancement.
C’est pour cessez de considérer la sortie comme la fin des tests.
Pour une organisation mature d’ingénierie de la qualité, le shift-right ne consiste pas à opposer les équipes QE, SRE ou développement. Il s’agit de fournir aux trois équipes de meilleures preuves sur le comportement du système lorsque cela compte le plus.
La prochaine étape consiste à commencer petit : un parcours critique, un SLO, un moniteur synthétique et un canari contrôlé.
Mesurez ensuite le résultat.
La production ne doit pas être considérée comme un lieu où les tests s’arrêtent. Avec la bonne observabilité, des garde-fous adaptés et une culture appropriée, elle peut devenir l’une des sources les plus riches d’informations sur la qualité dont dispose l’équipe.
Prêt à déployer des pratiques shift-right à grande échelle ?
Explorer Services d’Ingénierie Qualité de TO THE NEWpour un support de bout en bout : stratégie d'observabilité, configuration de la surveillance synthétique, définition des SLO, automatisation du déploiement canari et gouvernance continue.